GCL学术成果:SIGGRAPH Asia 2026-GALA:让大模型看懂三维几何,实现合理摆放物体
近日,SIGGRAPH Asia 2026 接收成果公布。来自中国科学技术大学数学科学学院 GCL 实验室与腾讯、清华大学、香港科技大学等单位的研究团队提出了 GALA(Geometry-Aware Language Model for Controllable Object Arrangement):一种面向可控物体摆放的几何感知语言模型。
给定已有场景、待摆放物体和一句自然语言指令,GALA 会结合物体与场景的点云几何,直接预测目标物体的 6D 位姿。它关注的不只是“桌子旁边放一把椅子”这类语义关系,还会判断椅背能否避开桌板、椅腿是否与桌腿碰撞、物体是否真正落在支撑面上。
研究团队还构建了由公开数据、程序化生成数据和美术制作场景组成的多源高质量数据集,并将 GALA 接入“规划—摆放—验证”的多阶段智能体流程,实现从文本描述到完整三维场景的自动生成。
一、问题背景:三维物体摆对很重要
三维场景的设计与生成广泛用于游戏、影视、建筑设计和具身智能训练。想象一下这样的设计师日常工作场景:游戏设计师要搭建一个书房场景,需要在书架里放进几本书,在书桌上放一台显示器和键盘,椅子要刚好塞进桌下。这个任务对人类来说很直观,因为我们能“看见”三维空间,知道书要竖着放进格子、椅子要正对桌子、显示器不能悬在桌沿外。
如果 AI 能自动完成物体摆放,设计师就能从繁琐的手动布景中解放出来,专注于创意本身。但让 AI 自动来完成该任务,远比你想象的困难:如何让 AI 像人类一样,同时理解“语义关系”(椅子应该朝向桌子)和“几何约束”(椅背不能穿透桌板、椅腿不能悬空)?
二、现有方法的不足:三维物体摆对为什么这么难?
场景搭建其实可以拆成一个迭代过程:每次选择一个物体、确定它在当前场景中的位置与朝向,再继续摆放下一个。
难点在于,物体摆放同时受两类约束影响:
- 语义约束: 例如“把椅子放到书桌下面”、“把书放进书架”、“让沙发朝向电视”;
- 几何约束: 物体不能碰撞或悬空,还要找到真实可用的支撑面和容纳空间。
但是,现有方法仍有两个关键不足:
表示层面: 物体常被简化成“方盒子”,几何细节在输入模型之前就丢失了。具体来说,现有方法通常使用定向包围盒(Oriented Bounding Box,OBB)表示物体,只保留中心、尺寸和旋转信息。这种表示适合规划粗粒度布局,却无法描述书架内部的空腔、桌腿的位置和沙发表面的弧度等局部结构。
模型层面: 大语言模型能理解文字指令,却不擅长利用三维几何信息进行空间推理。它知道“把椅子放到桌下”是什么意思,却难以判断椅背是否会碰到桌板、椅腿能否避开桌腿,以及放置后是否具有稳定支撑。换句话说,理解摆放意图并不等于知道如何在真实三维空间中把物体摆对。
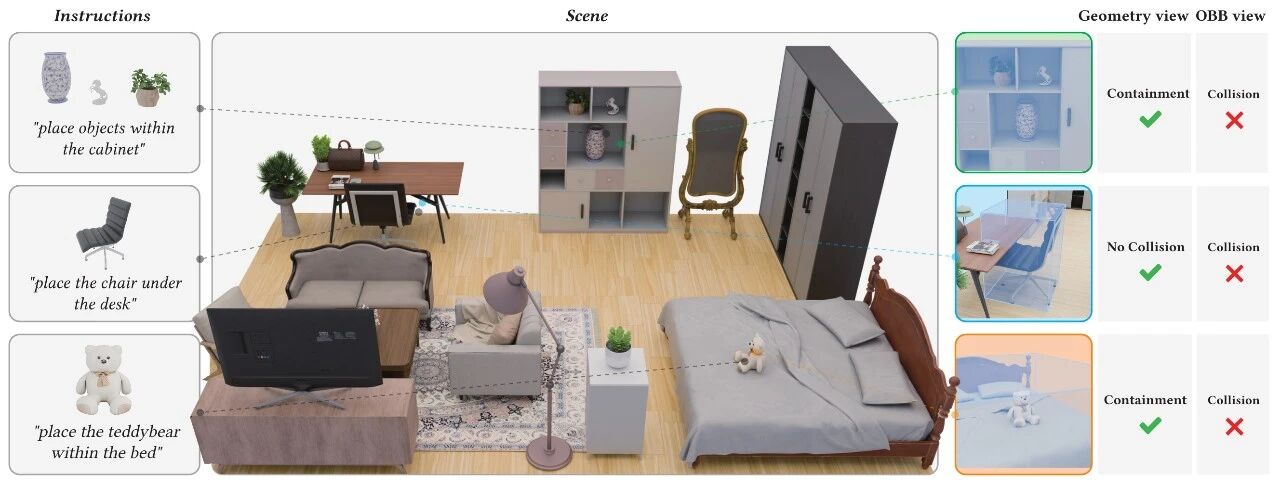
图1:GALA 通过几何感知处理支撑、包含和避碰等精细约束。
因此,问题既出在“提供给模型的形状信息不够”,也出在“模型缺少利用形状进行推理的能力”。要实现精细摆放,这两个层面缺一不可。
三、核心思路:给语言模型接入点云“视觉”,看清三维点云
我们的问题的输入是:场景边界、已经摆好的物体、待摆放物体,以及摆放指令。每个物体除了类别、尺寸和已有位姿,还带有独立的点云表示。输出是目标物体的 6D 位姿,包括三维位置与三个旋转角。
我们的 GALA 的核心思路很直接:既然语言模型缺的是“视觉”,那我们就给它接上一双“三维眼睛”,即,让语言模型在读懂摆放指令的同时,也能读取场景和物体的三维点云。
我们不把物体简化成方盒子,而是让模型直接看到物体和场景的三维点云。然后,把这些点云信息翻译成大语言模型能理解的格式,和文字指令一起输入。这样,模型在决定“把书放进书架”时,不仅能读懂指令的意思,还能“看到”书架内部到底有多少空间、书的厚度是多少、放进去会不会卡住。
这就是 GALA 的核心哲学:文字负责想清楚要摆什么,点云负责看清楚该怎么摆。两者结合,AI 才能真正摆对。
四、我们的解决方案
在模型结构上,GALA 采用三部分设计:
- 点云编码器: 使用自监督三维模型 Utonia 提取场景和物体的几何特征;
- 几何—语言投影器: 通过两层 MLP,把点云特征映射到语言模型的词向量空间;
- 语言模型骨干: 以 Qwen3-0.6B 为基础,同时读取文字 token 与点云 token,自回归生成目标位姿。
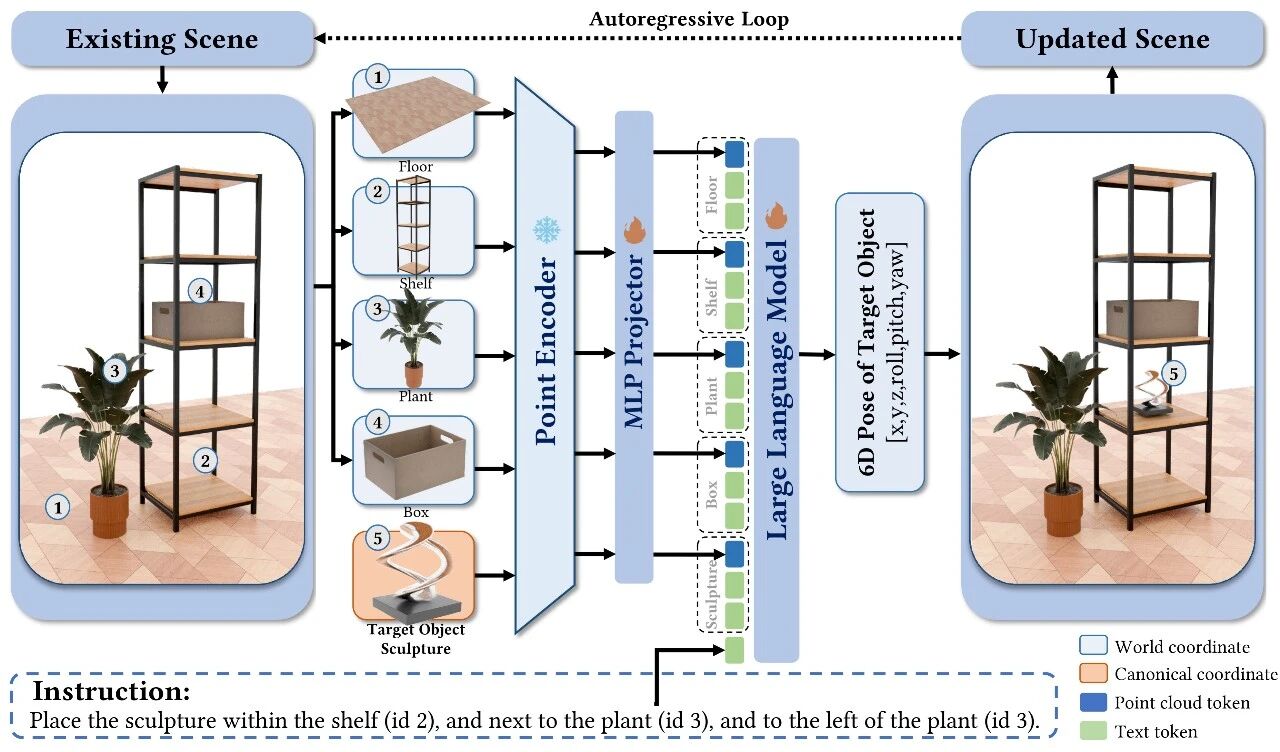
图2:GALA 的几何感知摆放模型。场景和各物体点云分别编码为几何 token,与文字 token 交错送入语言模型,最终预测目标物体的六自由度位姿。
为了避免不同物体的几何特征混在一起,GALA 会分别编码地面、已有物体和目标物体,再按照它们在提示词中的顺序,将几何 token 与文字描述交错输入语言模型。这样,模型能把“书架(id 3)”、“内部空腔的形状”、“把书放进去”对应到同一个上下文中。
摆放过程按物体逐步进行。每预测一个物体,系统就把它加入当前场景,再预测下一个物体的位置。复杂场景因此被拆成一系列可控的单物体摆放任务。
五、数据与训练:先让模型读懂几何,再学习摆放
高质量训练数据是精细摆放的另一块基础。公开室内场景中常有悬空、穿插、越界等噪声,包含“放进柜子”“摆到层板上”这类细粒度关系的样本也不够多。
研究团队整合了 3D-FRONT、Imaginarium、SpatialLM,以及 300 个由专业美术制作的场景。所有数据统一经过两轮筛选:先用几何检测处理悬空、严重穿插与越界,再渲染候选场景,由视觉语言模型评估布局合理性、视觉质量、风格一致性和语义关系。最后保留下 2W+ 个场景,包含 30W+ 个物体。保留下来的场景会被转成“单步摆放”样本。系统从场景关系中构建以地面为根节点的场景树,再按照广度优先顺序生成摆放序列。
训练分为两个阶段:
- 阶段一:几何—语言对齐。 冻结点云编码器和语言模型,只训练投影器。任务包括识别场景边界、物体类别、中心、尺寸、旋转,以及物体之间的距离等;
- 阶段二:自回归摆放训练。 继续冻结点云编码器,联合微调投影器与语言模型,让模型根据文字指令和几何上下文预测位姿。
完整模型约 0.7B参数。训练在 8 张 NVIDIA H20 GPU 上完成,两阶段合计约 7 小时。推理时,在单张 H20 上摆放一个物体仅需约 1 秒,显存占用约 3 GB。
六、实验结果:0.7B 模型超过 120B 零样本大模型
论文从指令遵循和几何合理性两个维度评估摆放质量。其中,“放入有效率”专门衡量物体能否正确放入容器,是最能反映局部几何推理能力的指标。
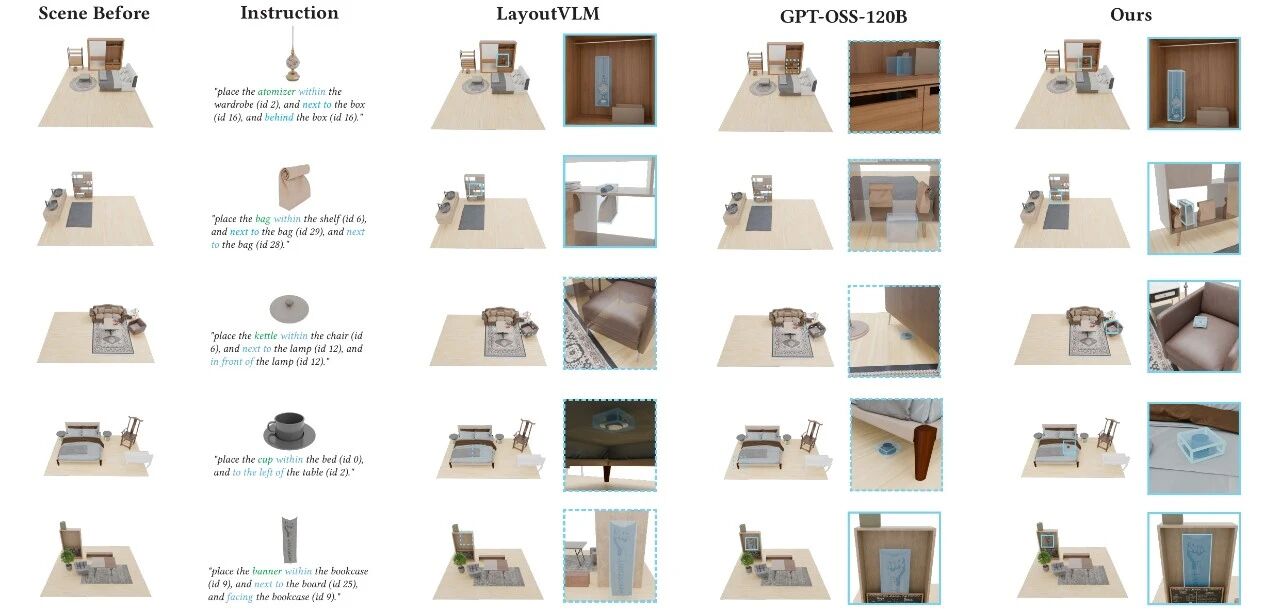
图3:单物体摆放的定性对比。GALA 能更准确地找到容纳区域和支撑位置。
GALA 的“放入有效率”达到65.62%,明显高于 GPT-OSS-120B 的22.53%;整体指令有效率达到78.59%。这说明参数规模并不是决定因素:面对需要判断空腔、支撑面和局部可用空间的任务,显式几何输入更重要。
消融实验也给出了同样的结论。去掉点云后,“放入有效率”从 65.62% 降至 62.40%,悬空率升至 5.19%;去掉第一阶段的几何—语言对齐后,该指标降至 62.69%。去掉美术家场景后,放入有效率进一步降至 60.32%。点云、对齐训练和高质量场景数据解决的是不同问题,缺少其中任何一项,精细摆放都会受影响。
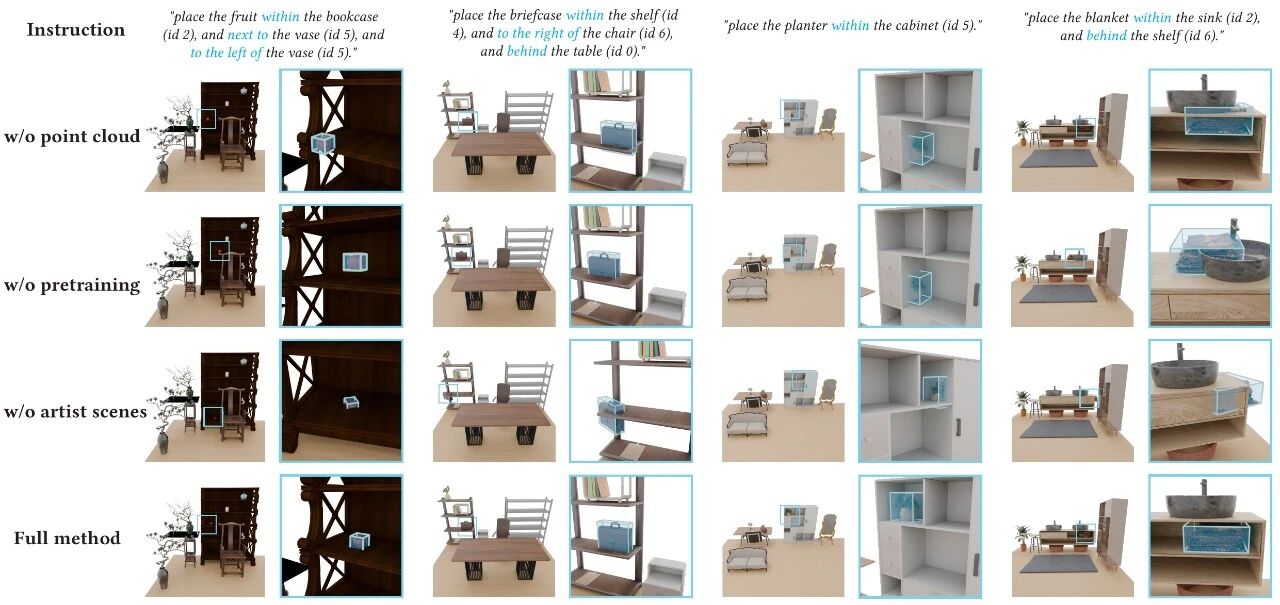
图4:消融实验的定性结果。移除点云、对齐预训练或高质量场景后,模型更容易出现放置越界、悬空和与容器结构不匹配等问题。
在 30 名志愿者参与的用户研究中,GALA 的单物体摆放在物理合理性和指令遵循上均得到 4.5/5;完整场景的物理合理性与美观度分别得到 3.9/5 和 4.1/5,同样大幅领先对比方法。
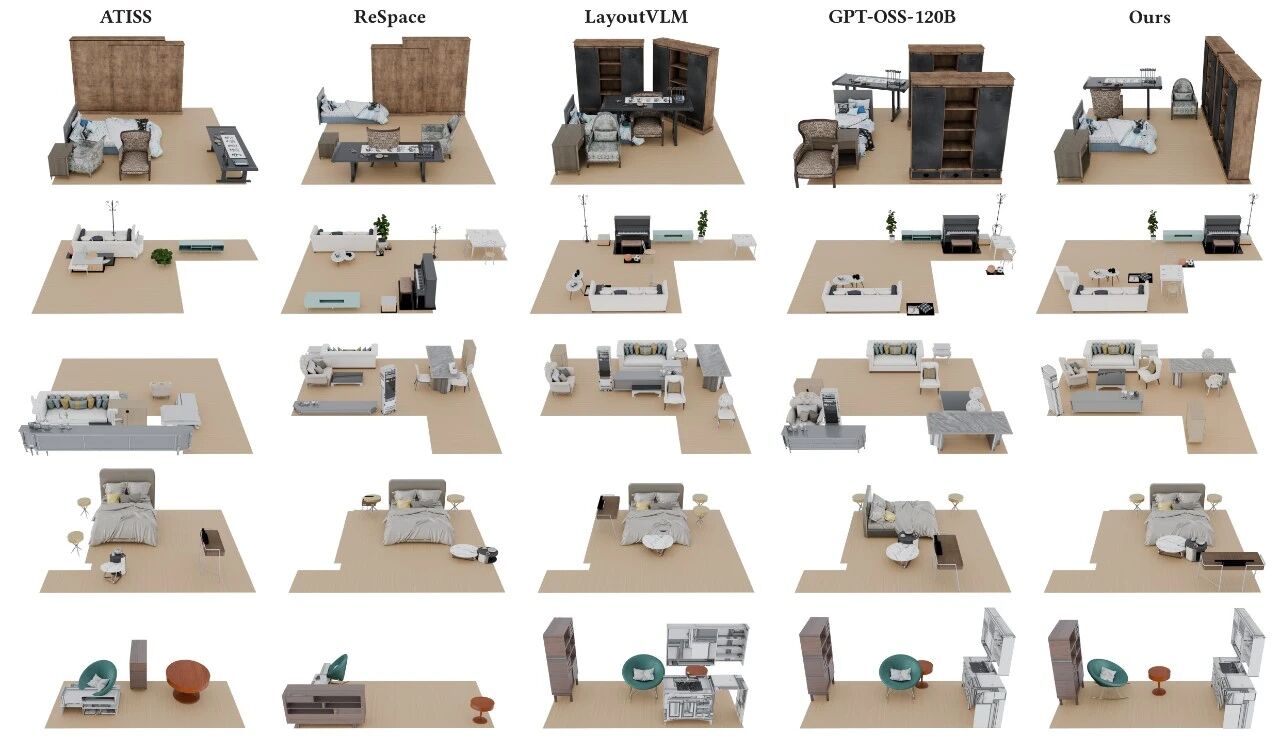
图5:不同方法在自回归生成中的定性对比。GALA 生成的布局整体上更加合理。
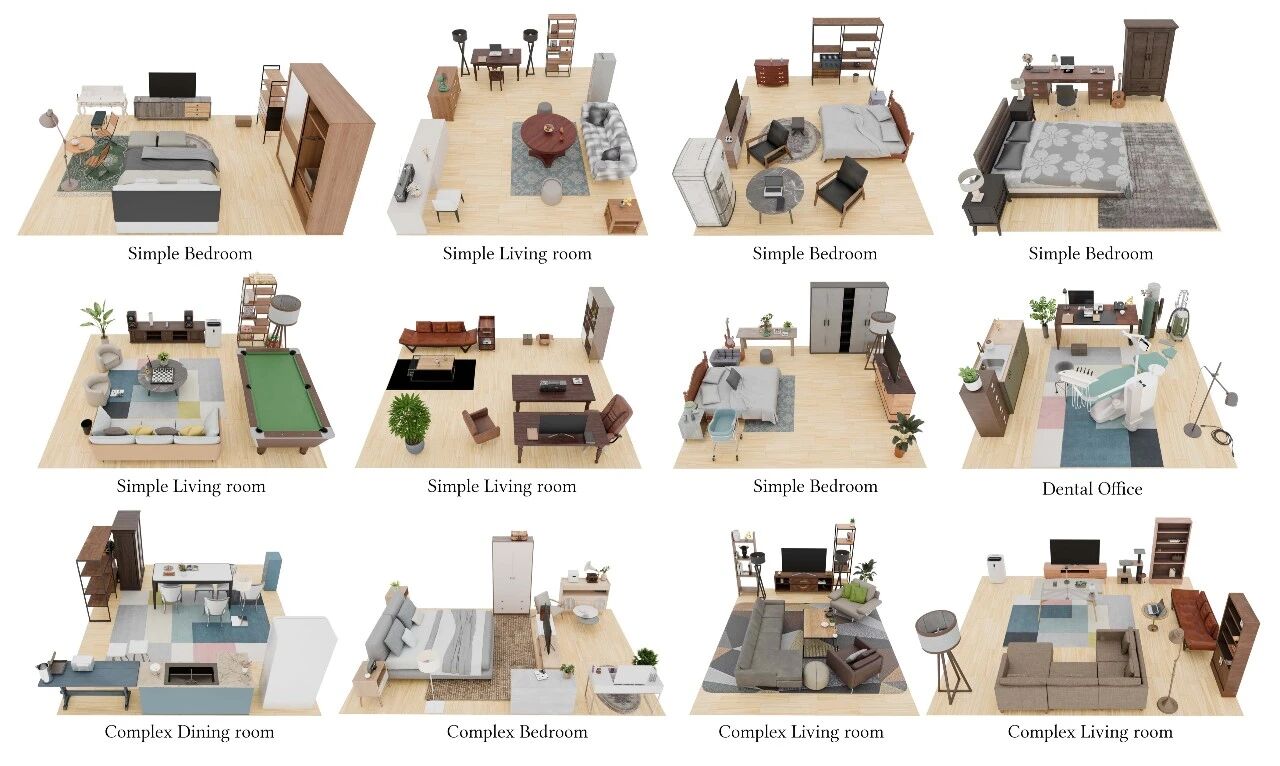
图6:更多测试集推理结果。GALA 在不同房间类型与物体密度下均能逐步生成满足指令、具有合理支撑关系的场景布局。
七、从单个物体到完整场景:“规划—摆放—验证”智能体
单物体摆放模型只是起点。为了让用户直接用一句话生成完整场景,研究团队把 GALA 接入了一个多阶段智能体流程。
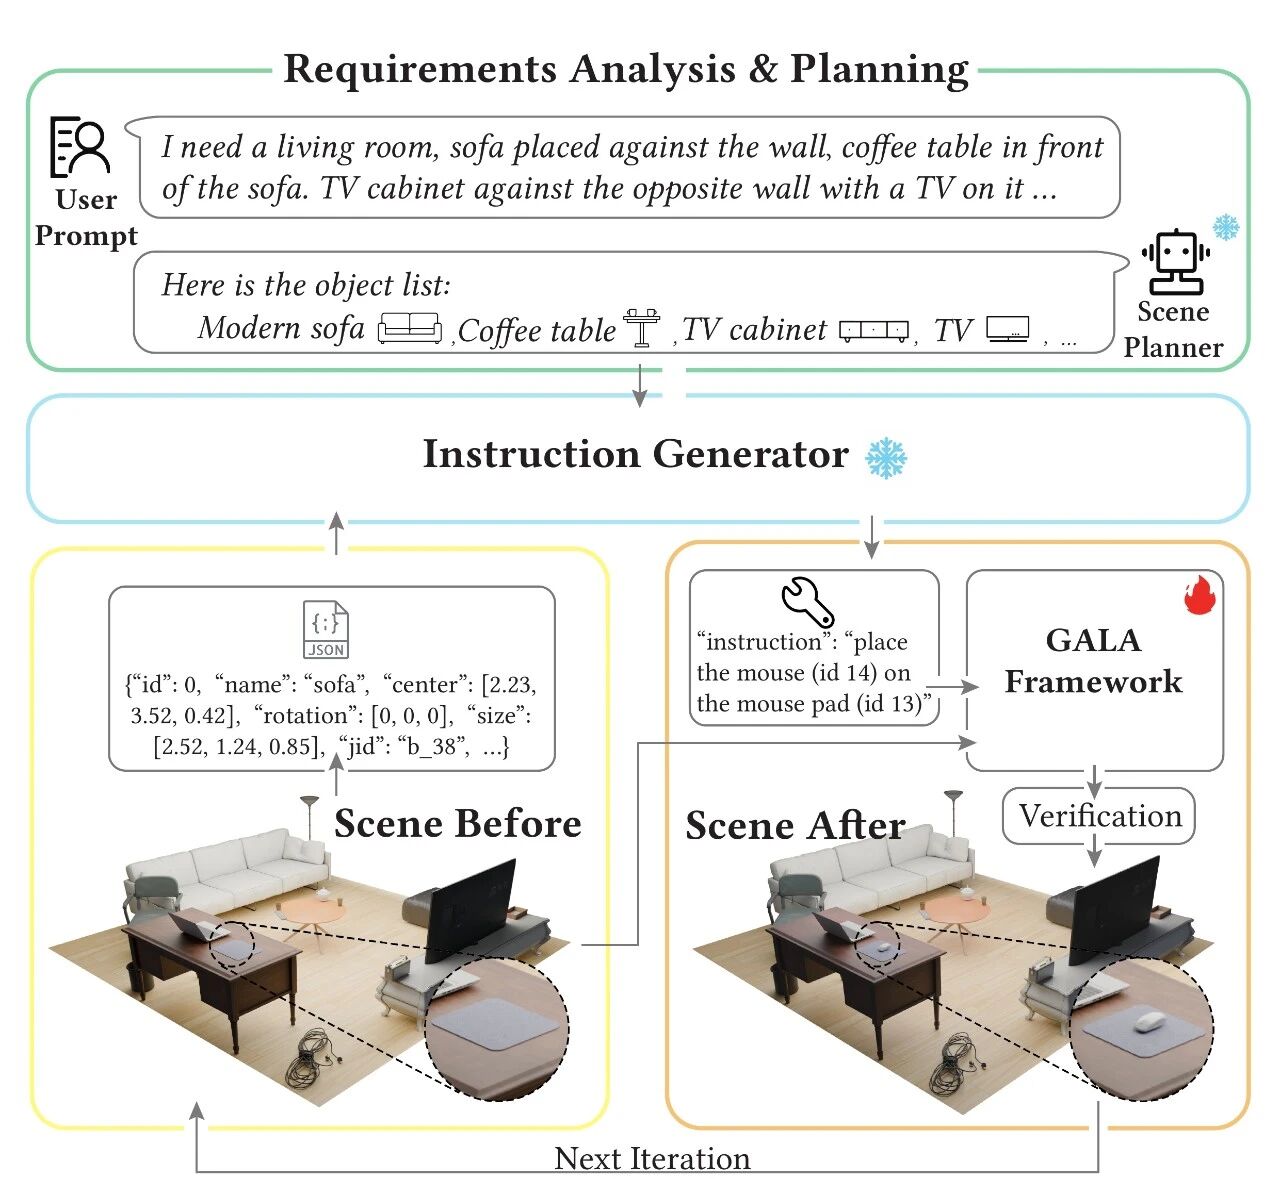
图7:文本驱动的多阶段 Agent 式场景生成框架。
这套流程把语义决策和数值预测分开:
- 规划(Plan): 通用语言模型把用户描述拆成有顺序的物体清单,给出类别、描述、估计尺寸和依赖关系;
- 摆放(Place): 指令生成器读取当前场景,为下一个物体生成关系明确的摆放指令;GALA 根据指令和点云预测六自由度位姿;
- 验证(Verify): 检查物体是否越界、碰撞、悬空,以及是否满足指定关系。若发现问题,反馈给指令生成器重新调整。
例如,用户只需描述“生成一个带书桌、椅子、书架和桌面用品的书房”,系统便可先放置大型锚点家具,再逐步加入书本、显示器、键鼠等小物体。每一步都能利用已经生成的场景作为上下文,而不是一次性猜出整套布局。
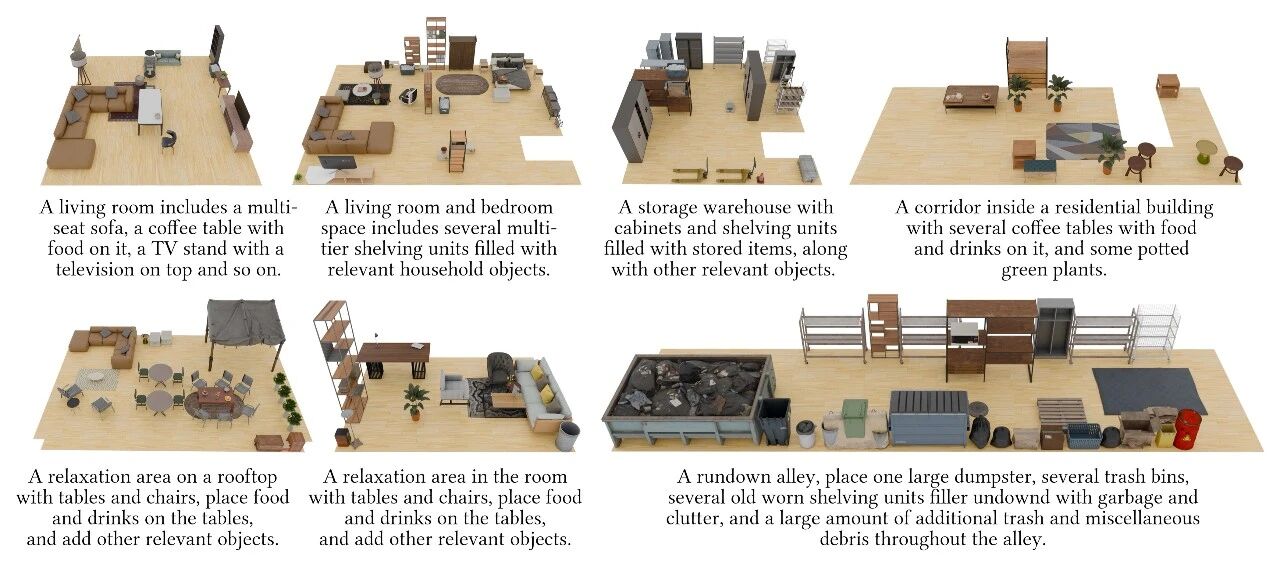
图8:Agent 场景生成结果。该流程能够根据文本需求生成客厅、储物空间、走廊、屋顶和室外巷道等不同类型的完整三维场景。
八、总结与展望
GALA 的核心贡献是:将三维点云几何与语言模型深度融合,让 AI 真正“看懂”形状,从而实现符合物理规律的三维物体摆放。 它用约 0.7B 的紧凑模型,在细粒度包含关系和整体指令遵循上超过了更大的零样本模型,也能嵌入智能体流程完成文本驱动的场景生成。
目前,GALA 仍依赖预定义的指令种类,对未见过的容器几何泛化有限;自回归摆放也可能让早期误差传到后续步骤。后续工作将面向开放式编辑指令和部件级几何监督继续扩展,并探索先判断支撑面和可用空间、再输出位姿的显式 CoT 式思考过程。
这项研究为游戏关卡生成、虚拟内容制作、室内设计和具身智能仿真提供了一条实用路线:让通用模型负责“想清楚要摆什么”,让几何感知模型负责“真正把它摆对”。
论文发表
该工作已被计算机图形学国际会议SIGGRAPH Asia 2026 Conference Track接收。
论文信息
论文题目: GALA: Geometry-Aware Language Model for Controllable Object Arrangement
作者: 项楚成(1,2)、王润泽(1,2)、邓治(2)、鲍汝超(1,2)、张院伟(2,3)、谢宇轩(2)、王涵柳(2)、费梁树(1,2)、吴汶政(1,2)、万城(2,4)、李培锋(1,2)、刘中远(2)、刘利刚(1)
作者单位: 中国科学技术大学(1)、腾讯(2)、清华大学(3)、香港科技大学(4)