GCL学术成果:SIGGRAPH Asia 2026-SDFAvatar: Animating Generative SDF Grids for One-Shot Avatar
近日,SIGGRAPH Asia 2026 接收成果公布,来自中国科学技术大学数学科学学院 GCL 实验室的张举勇研究团队提出了一种从单张图像生成可驱动三维头部数字人的新方法——SDF-Avatar。该方法将三维生成模型的几何先验与 SMPL-X 参数化模型的结构控制能力相结合,在保留头发、配饰等复杂几何结构的同时,实现了拓扑一致、时序稳定的表情与姿态驱动。
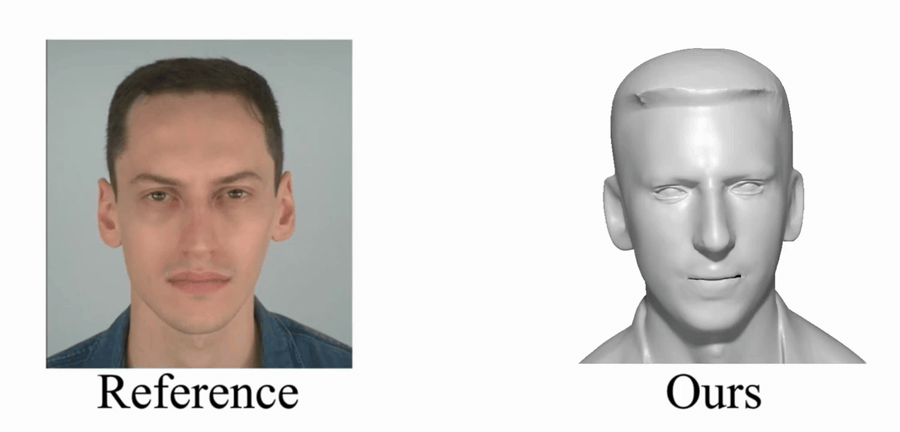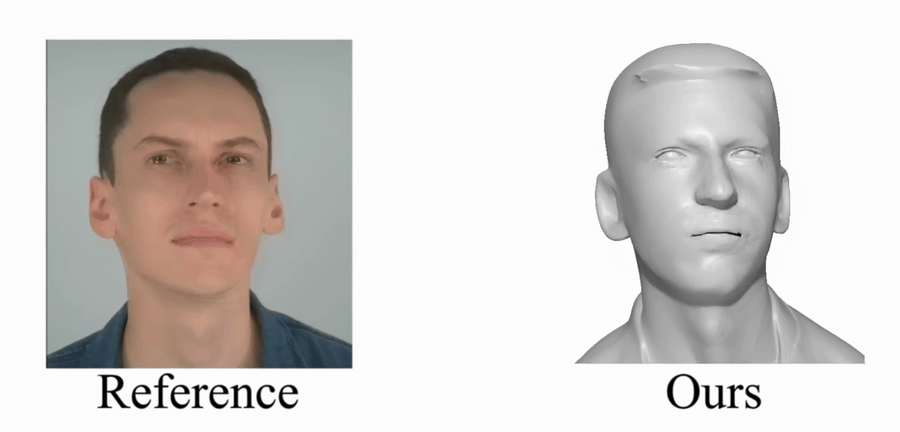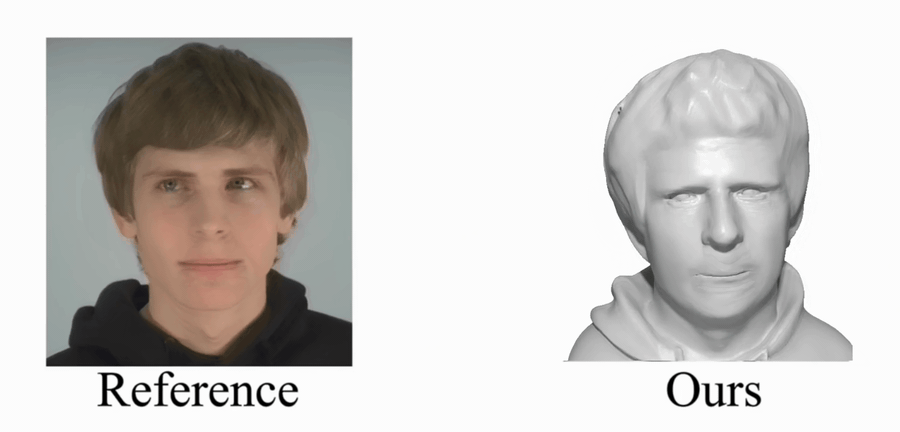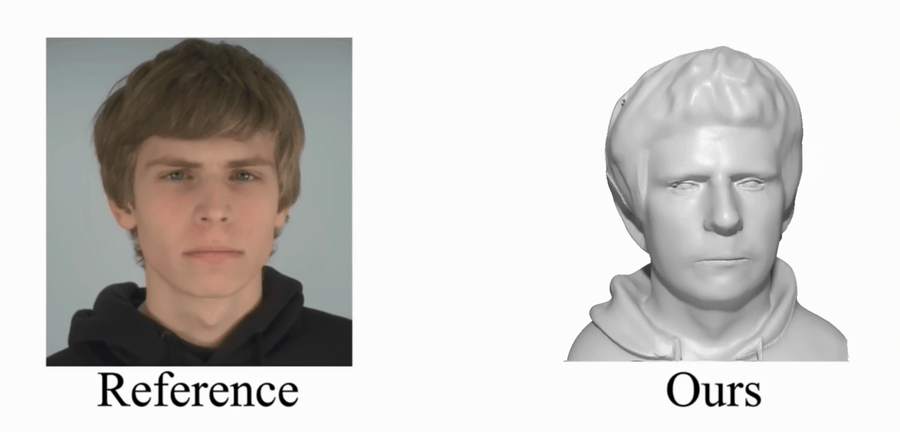
SDF-Avatar 从单张图像重建可驱动的三维数字人头部
一、研究背景
从单张图像生成三维数字人头部,是计算机图形学与计算机视觉领域长期关注的问题,在虚拟现实、远程通信、游戏和数字内容生产中具有重要的应用价值。高质量的数字人头部不仅需要准确还原人物的面部身份,还要完整表示头发、配饰等结构,同时要能够在新的表情和姿态下自然驱动。然而,单张图像只包含一个视角的信息,无法提供完整的几何约束,被遮挡的区域和头部背面都只能依靠先验推断,单目条件下的重建本身就是一个高度欠约束的问题。此外,可驱动的数字人对几何还有更高的要求:不仅人物身份要在驱动过程中保持一致,头部几何还必须具有稳定的拓扑结构,这样才能实现精准的驱动效果。
现有方法主要分为两条路线。以 SMPL-X、FLAME 为代表的参数化模型具有统一的拓扑和明确的表情、姿态参数,驱动稳定,但几何受限于固定模板和低维参数空间,难以表示复杂的发型和配饰;以 TRELLIS 为代表的三维生成模型则能够从单张图像推断出复杂的自由拓扑几何,在头发、配饰等区域优势明显,但生成结果只是一个静态的三维图像,没有骨骼和表情参数可供驱动,在眼睛、鼻子、嘴唇等决定身份的关键区域也可能引入偏差。因此,如何在保留生成模型几何表达能力的同时引入参数化模型的结构约束和驱动能力,是从单张图像生成可驱动数字人的关键问题。
二、方法概述
SDF-Avatar 的核心思想是将两类模型的优势相结合:由生成模型恢复高精度头部几何,由参数化模型提供结构和运动控制。首先,作者通过生成模型内部的稀疏体素表示衔接起来。TRELLIS 先在一组稀疏体素上预测几何特征,再由解码器把特征转换为 SDF 并提取出表面。这些体素分布在表面附近,分辨率远低于最终网格,可视为包围表面的低分辨率控制结构,用于驱动表面形变。
SDF-Avatar 将这一结构作为神经形变笼(Neural Deformation Cage)。驱动时,SMPL-X 的形变场提供运动引导,体素上的特征信息保持不变。变形后的体素经过解码器得到 SDF,再提取出新表情、新姿态下的网格。由于特征和解码器在驱动过程中保持固定,输出网格在不同帧之间保持拓扑一致,头发、配饰等复杂结构随头部整体运动,从而保证网格不会出现撕裂和穿插。
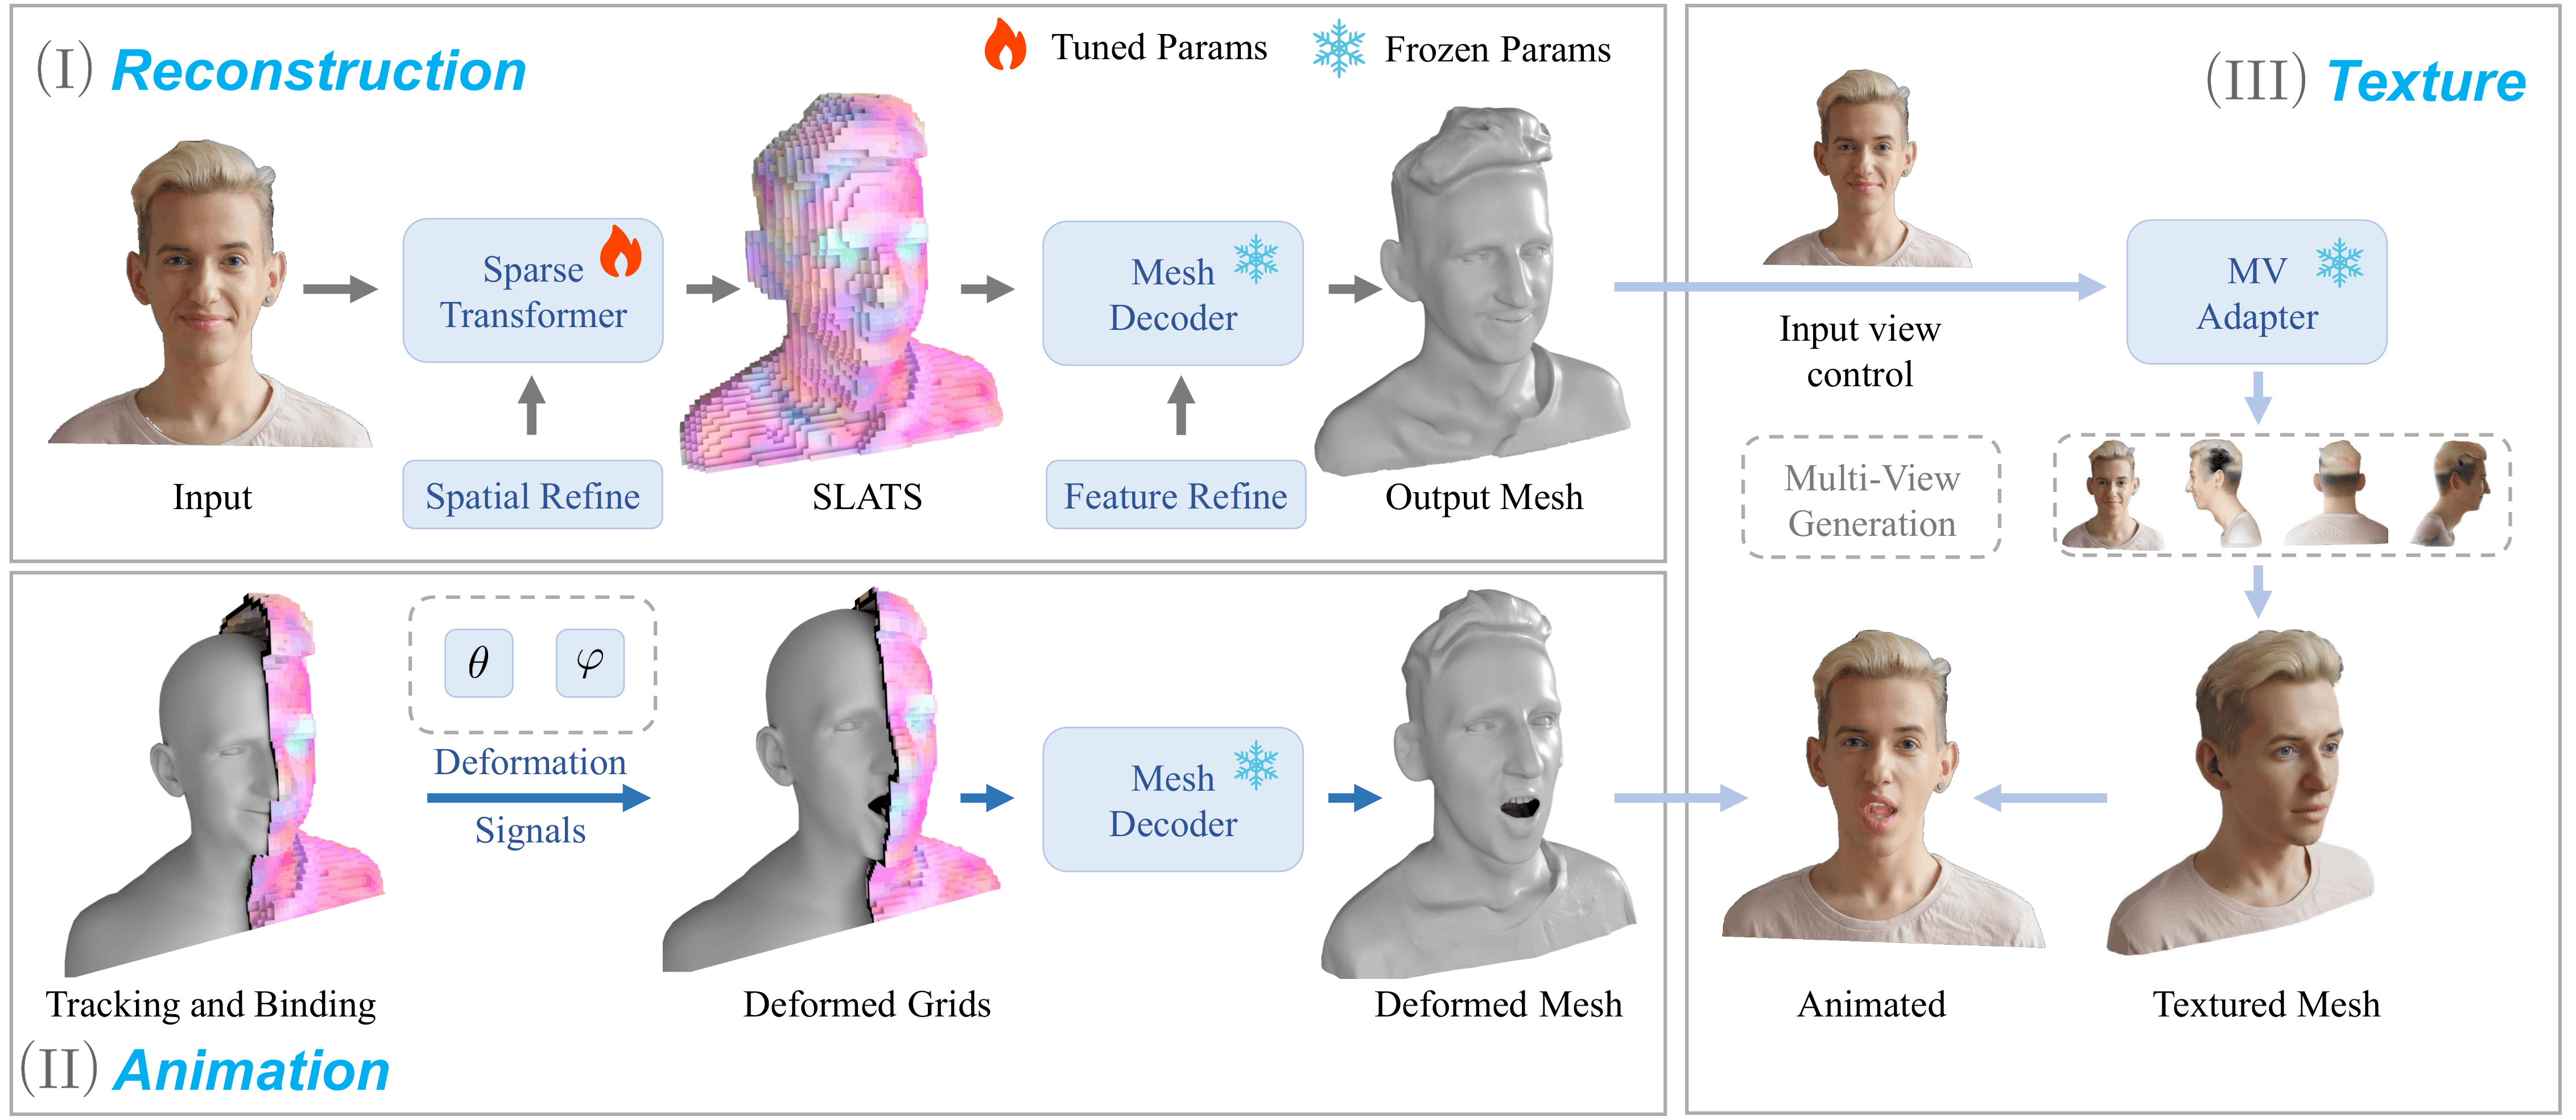
图1 SDF-Avatar整体框架
三、实验结果
论文在头部几何数据集 FaceVerse 以及 VFHQ、CelebV-HQ、NeRSemble等人像数据集上,对重建、驱动和新视角渲染进行了实验。与基于固定拓扑模板、神经隐式表示或三维高斯的方法相比,SDF-Avatar 保留了更丰富的高频几何,在复杂发型和配饰区域的拓扑更加完整、表面更清晰。在自驱动和跨身份驱动任务中,表情和姿态迁移稳定,动画过程中人物身份和几何保持一致;从侧面和背面观察时,几何和外观也更加完整。
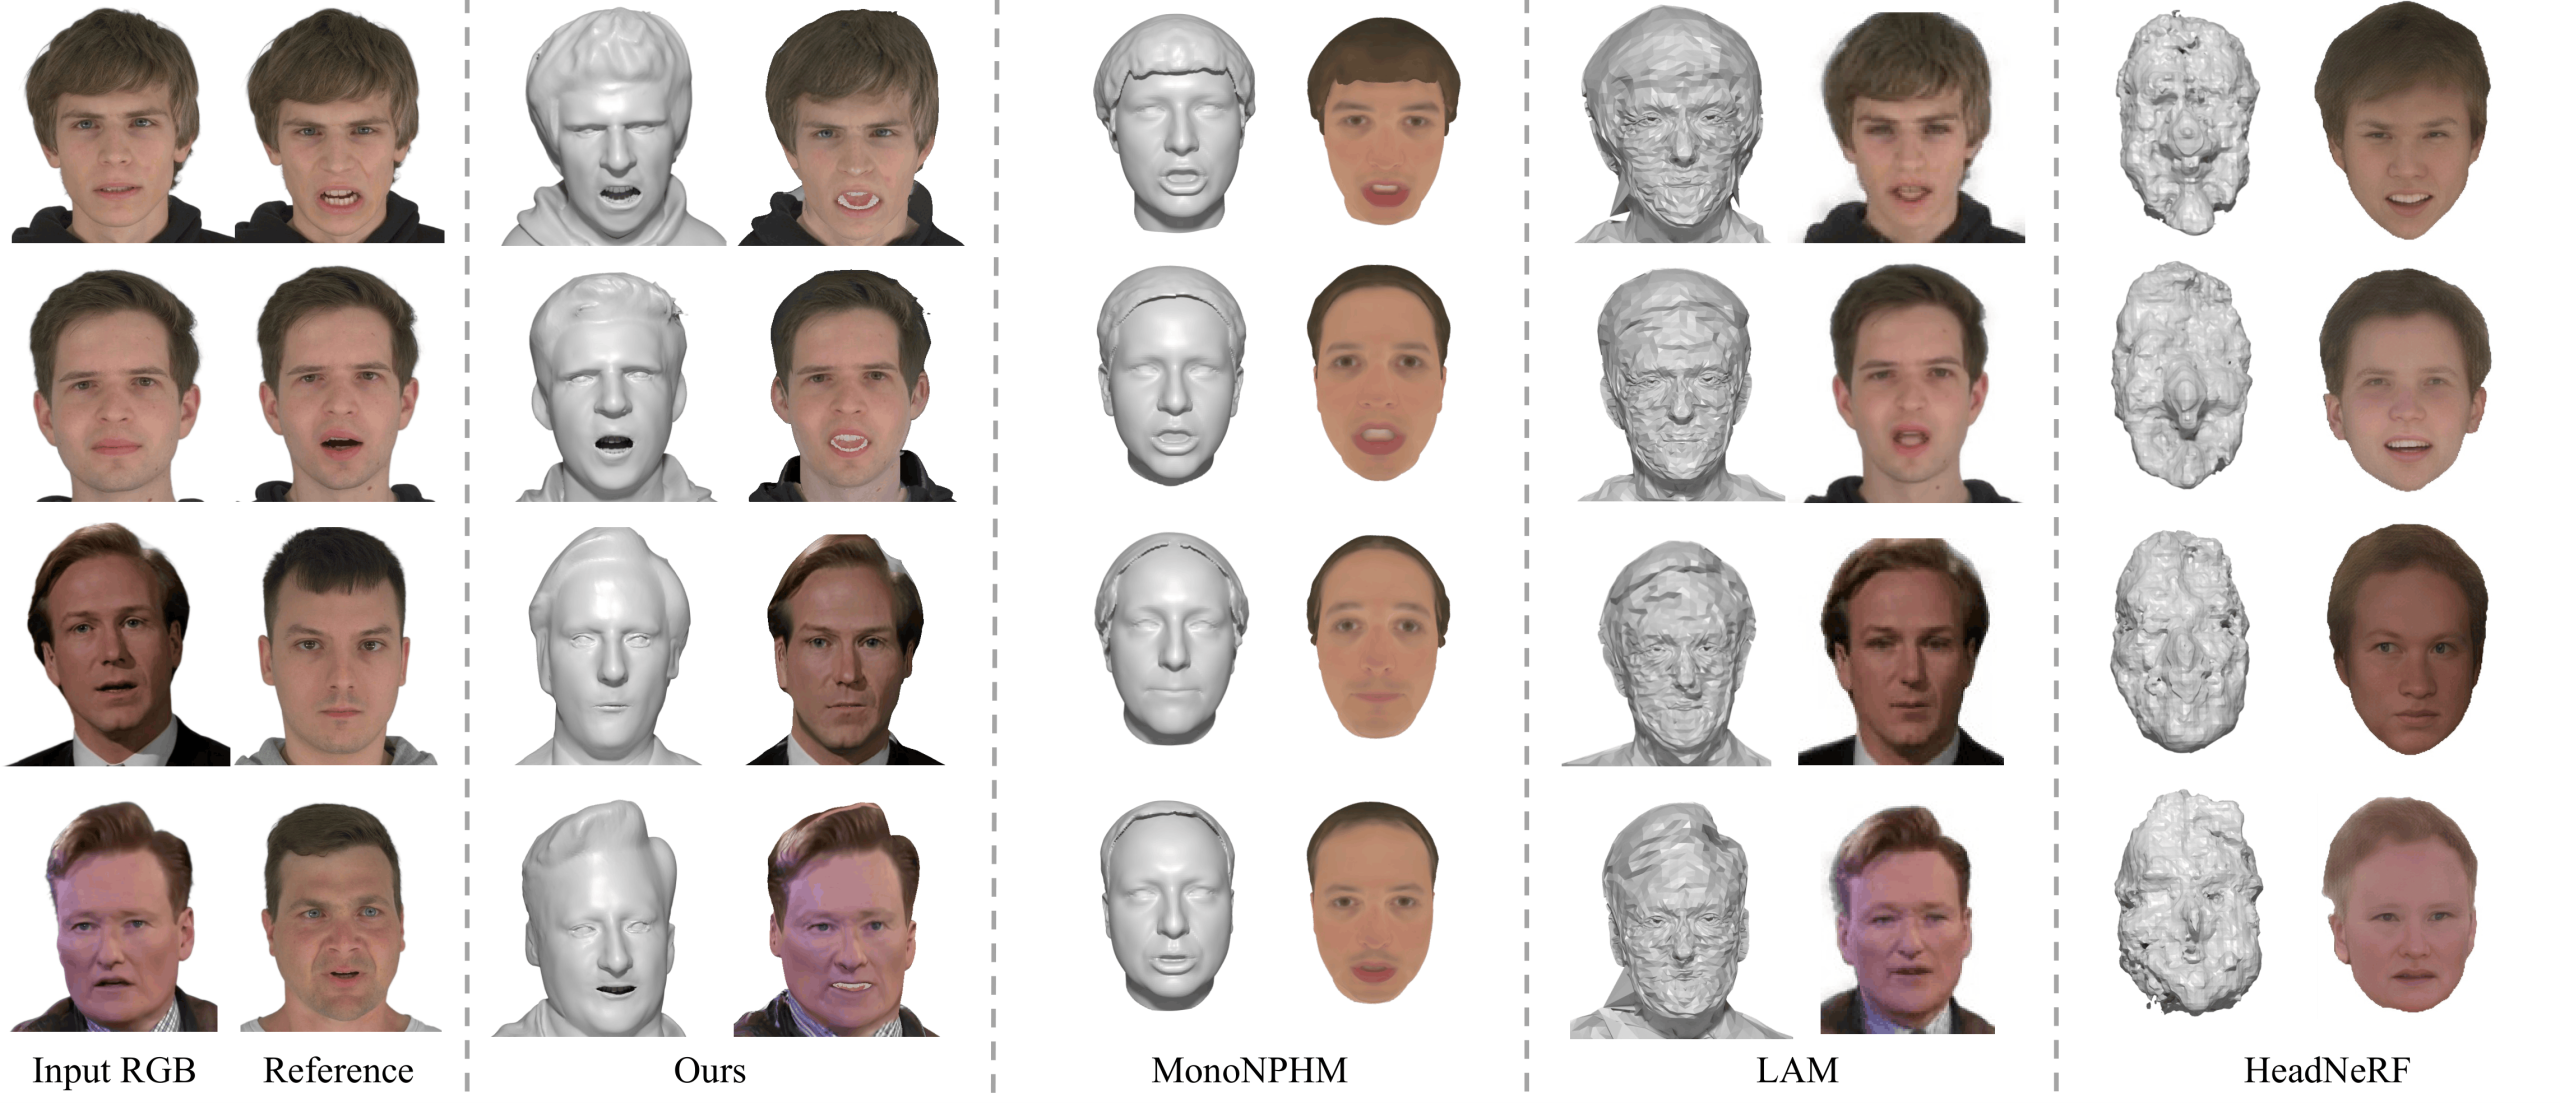
图2 SDF-Avatar与现有方法在自驱动和跨身份驱动任务上的比较
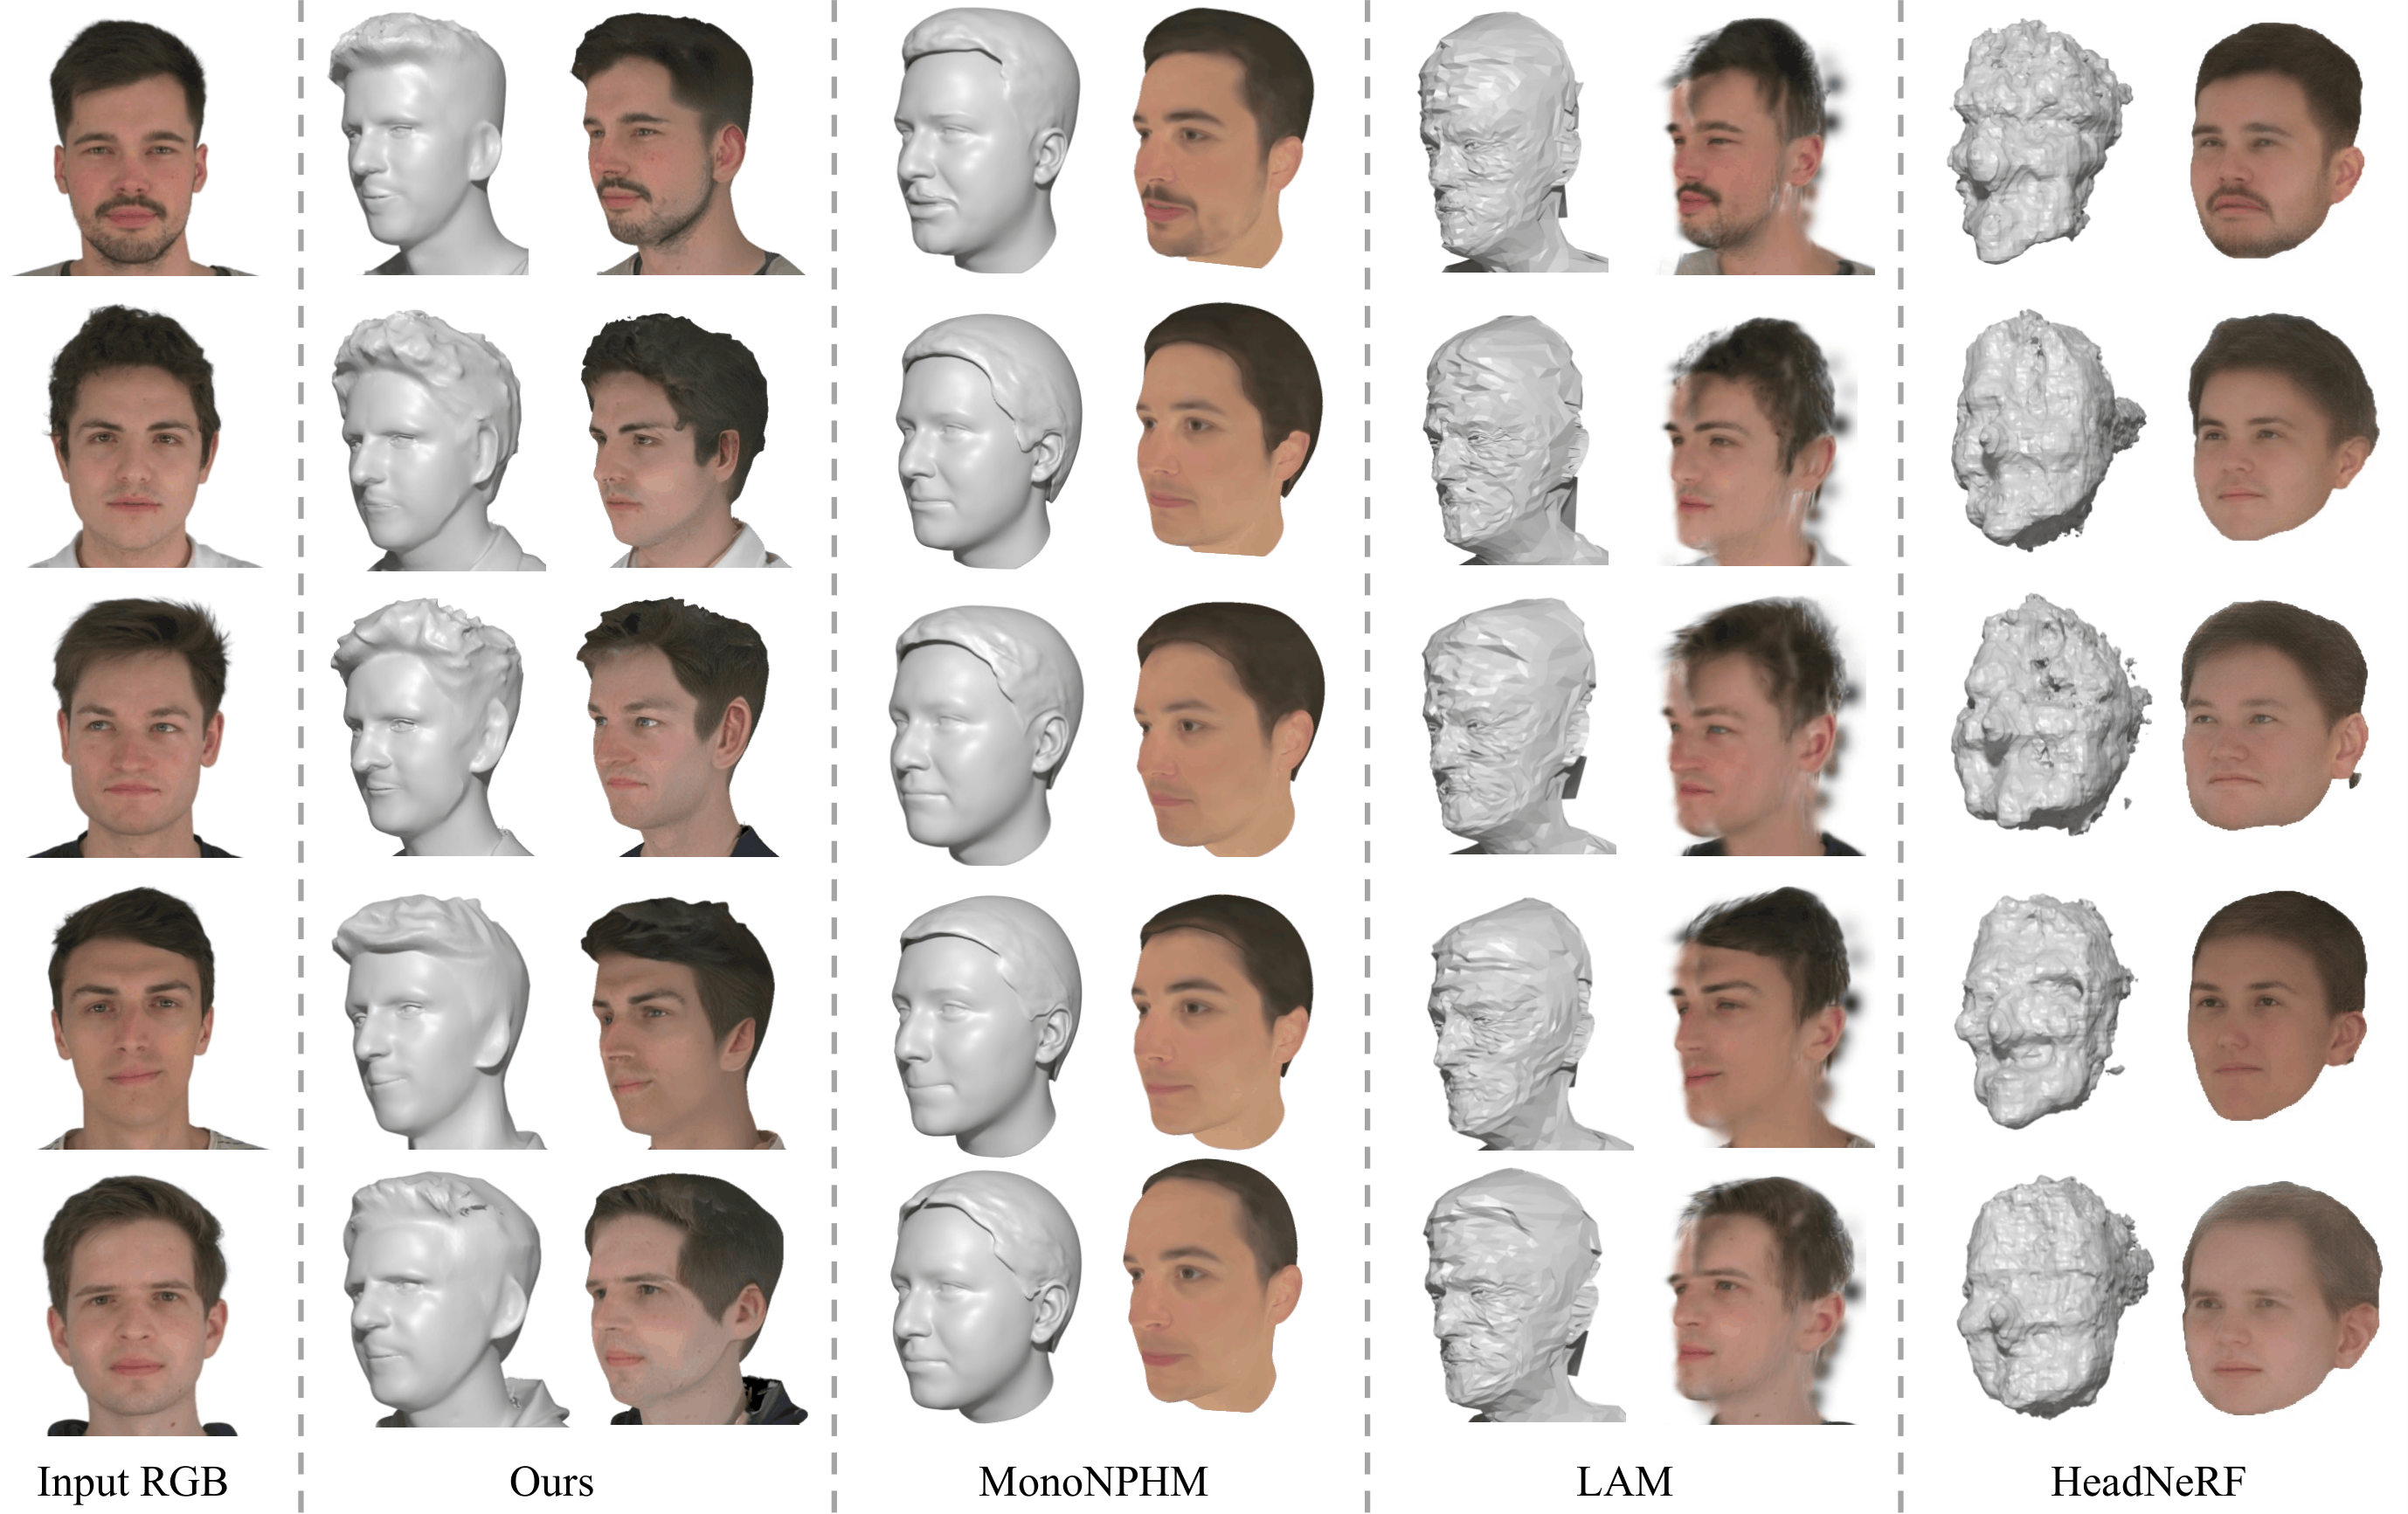
图3 SDF-Avatar与现有方法在新视角下的渲染结果对比
四、总结与展望
SDF-Avatar 将三维生成模型的稀疏体素表示重新解释为神经形变笼,用 SMPL-X 的形变场驱动体素,使三维头部数字人在保留头发、配饰等自由拓扑结构的同时,实现时序稳定的高保真驱动。未来,该方法有望从头部扩展到全身,并结合物理模拟为头发、服饰等结构引入仿真效果,得到更加真实、可控的数字人。
论文发表
该工作已被计算机图形学顶级国际会议 SIGGRAPH Asia 2026 接收。
论文信息
论文标题: SDF-Avatar: Animating Generative SDF Grids for One-Shot Avatar
作者: Zhijun Wang, Yudong Guo, Xujing Chen, Junxi Zhang, Juyong Zhang
单位: 中国科学技术大学